本文的目的主要是表達某個觀點,而不是論證某條路是否可行。
我想可能可以重新讀一遍?我修復了一點邏輯問題。
主要是最後幾段啦。
一切討論的起因
討論從 Twitter 上的 meme 開始。
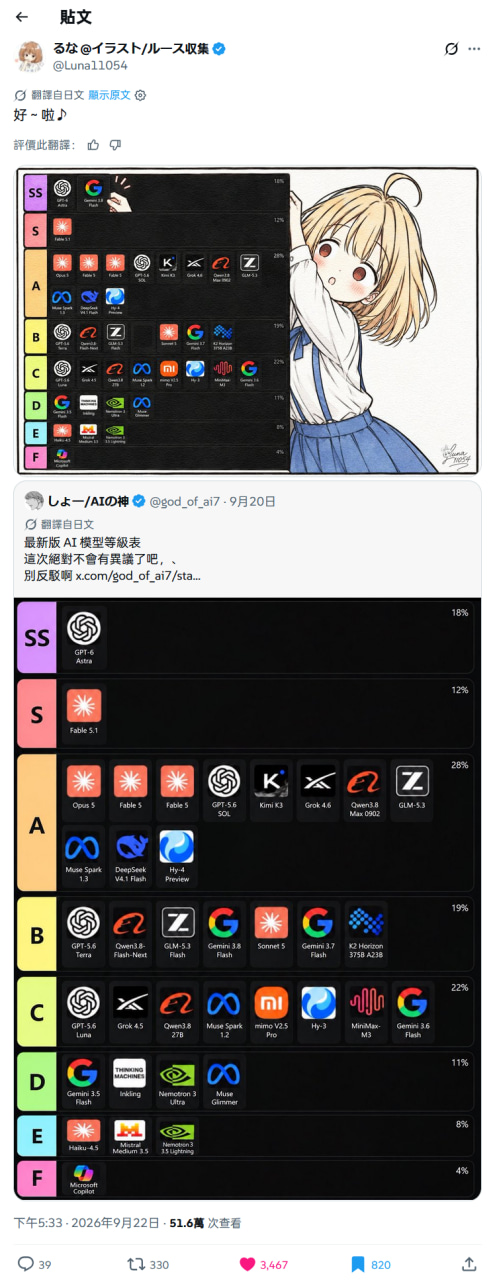
一個擬人化的 Gemini 形象正在把 Gemini 3.8 Flash 移動到某張 LLM Model 排行榜中的 SS 評級(也就是該表的最高評級)的位置。
我分享這張圖原本也只是出於“啊這個好可愛啊”的想法,不過卻收到了“排低了”的回覆。
點擊展開圖片
他說:自己在 Ubuntu Touch 上嘗試使用 Codex 修復 Waydroid 的網路連接問題,使用 Codex 無法解決,但是使用 Antigravity 成功修復了。
他認為,Gemini 的 IT Ops 能力是很強的,而 Vibe Coding 並不是我們所需要的一切,Gemini 最大的優點是沒有短板,而這是很多模型非常欠缺的。
是啊,究竟是什麼時候,我們將 LLM 的評分標準完全建立在 Vibe Coding 能力之上了呢?
依稀還能記得 ChatGPT 第一次火爆的時候,我們討論的是 AI 的知識域是否足夠廣泛,討論的是 AI 寫的文章字裡行間是否有經過斟酌的意味。
看著 AI 一路走到現在這個境地,即使是不怎麼對其加以研究的我,也隱隱約約覺得在什麼地方出了點問題。
始於 Codex,成於 SWE-bench
故事要從「昔々」說起,這大概是大部分人(包括我)都還沒有開始接觸 LLM 的時候。
大概是 2021 年年中,OpenAI 發表了專門針對程式碼生成的大模型 Codex,並同時推出了 HumanEval 基準測試。
這是我們第一次發現用出題讓 LLM 寫 Python 函式,是一種可以量化、精準評價 LLM 能力的方式。
但是我們並不在意—— 2021 年的 LLM 能夠編寫的程式碼還不夠好,無法直接應用在實際的開發中。
還要再等。
兩年過去,GPT-4 問世了。
純粹寫文章、問答、翻譯、總結,這些 “language” 的任務對於 LLM Benchmark 而言太過於簡單了。
相對的,coding 能力能夠直接反應 LLM 的邏輯鏈和糾錯能力,因此 HumanEval、MBPP 等 Coding Benchmark 開始被各大模型論文放在核心版面。
而到傳統文字測驗徹底被淘汰,還有半年。
2023 年年底,傳統文字測驗已幾乎被各大模型刷爆,發生了嚴重的題庫污染。
這時 SWE-bench 和 LiveCodeBench 出現了。
業界開始達成普遍共識:Coding 能力就是衡量模型綜合推理能力與 Agent 能力的最佳指標。
為什麼 coding 能力能成為衡量模型綜合推理能力與 Agent 能力的最佳指標?
因為 coding 能力是客觀的——不報錯就是通過,報錯就是不通過,可以輕易的、客觀的量化能力;
因為 coding 中出現邏輯錯誤、語法錯誤會直接導致崩潰,能夠相較於文字答題更精確的考驗模型長距離推理、指令追尋和規劃能力;
以及最重要的商業價值更高,Vibe Coding 是文字生成的應用場景中能夠最快變現並替工程師節省時間(即使我們現在站在上帝視角看,節省的 coding 時間全都變成 review 時間了,總耗時並沒有減少)的領域,能夠搶到最多的 ToB 訂單。
自然而然的,coding 成為了 LLM 廠商間的“兵家必爭之地”。
這個衡量模型訓練成果的 agent,變成了模型訓練的 target。
妥協與困局
一切妥協始於 2023 Q3。
Meta 推出 CodeLlama 時,大家發現用海量程式碼進行後訓練可以輕易地提升模型的 coding 能力。
那麼代價呢?
代價就是一般日常對話、文學創作和常識問題能力明顯退化,出現了嚴重的災難性遺忘。
至此市面上的模型開始出現了 coding 好但偏科的傾向。
2024 Q1,OpenAI 開始在 post-training (RLHF / DPO) 中瘋狂刷結構化格式與指令遵循。
目的是讓模型在 coding 和 function calling 時 100% 聽話、100% 遵守格式。
代價是什麼?
代價是模型的語言表達變得極度機械化、死板,喪失了 GPT-4 早期豐富細膩的語調、幽默感與同理心。
接下來是 SWE-bench 的火爆。
Q1 火爆的 SWE-bench 導致的 CoT 軍備競賽,終究是反映在了年中的新模型上。
各大廠商開始將「修真實的 GitHub issue」作為最重要的買點之後,模型的訓練數據被大量的技術文件、Stack Overflow 問答與 diff 補丁淹沒。
模型開始將所有問題當作 debug 題來解,甚至是讓他寫詩、聊天,模型都習慣性的列式、立 flag、做架構分析。
自此,文學性與發散性思維再無人關注。
我們究竟妥協了什麼?
Coding 和 function calling 追求的精準無誤,與文學創作需要的模糊美與發散性思維是矛盾的。至此,模型喪失了靈性。
模型開始遇事 1. 2. 3.(甚至我寫文章時 VSCode 的自動補全也建議我給這一段改成 1. 2. 3.),說話如同終端機一般。至此,模型沒有了情感。
我們進入了 Vibe Coding 的時代。
在 coding 之外
為何 Gemini 能修好的網路連接,被評價為「更聰明」的 GPT 修不好?
Coding 和 IT Ops 之間到底有多少區別?
無論編寫的是程式碼、配置文件還是 shell 指令,難道不都是一樣的標準化、結構化且不可出錯的文本嗎?
為什麼 agent 能搞定其一,卻無法搞定另一?
不巧的是,coding 和 ops 之間最大的差異並不在能夠被量化為分數的部分。
Coding 面對的問題通常是已被定義好的。
模型要解決的問題,不是人在背後提出的要求,就是某一個具體的 issue。
Issue 能解決,就是完成了目標;要求達成了,也是完成了目標。
但 ops 不一樣。
Ops 大部分時候我們只是看到問題的某一個表徵。
面對問題的表徵,我們需要猜「會不會是xx的配置文件錯誤導致了oo最後引發了該問題?」「啊不對不對,也有可能是因為xx崩潰導致了oo無法收到預期內的回應。」
針對同一個表徵,會出現大量的猜想。不過正確的往往只是其中的少數。
有了猜想,就要開始驗證我們的猜想。
從系統的什麼地方抓 log?systemd-journald 輸出?dmesg?還是檔案系統下的某個日誌文件?
抓系統什麼模塊的 log?抓 firewalld?抓 NetworkManager?還是抓 dnsd?
靠著抓到的資訊,推斷下一步可以做什麼,可能產生什麼後果(別告訴我你剛學 ops 的時候沒有出現過 ssh 上去配置網路介面然後一重啟直接就斷開 ssh connection 的經歷),什麼可以做,什麼做之前需要額外的準備,什麼有可能是問題所在但是還不能碰。
接下來就是建立新的猜想、獲取新的資訊和做新的嘗試這一流程的循環。
Coding 可以把問題本身固定下來,再看模型能不能找到正確答案。
但是 ops 很多時候需要的是「先別碰,我需要更瞭解系統的環境才能做出決斷」。
我們根本做不到產出可以直接交給模型的問題,模型首先要做的,是從有限的現象中判斷:究竟什麼才值得被當成問題,還缺少什麼資訊,下一步應該問什麼,以及現在到底能不能動手。
在知道「現在應該幹什麼」之前,還需要先回答「我的權限能做到什麼?」「我的操作有多大風險?」「如果我的操作搞砸了,我能否恢復操作之前的環境?」「我要不要先 backup?」「我需不需要先 ro investigation?」
這也是為什麼,Coding 很容易被做成 benchmark,而 Ops 很難。
Coding 能力是解決問題的能力,
而 ops 能力,是從現象中定義問題的能力。
前者可以用「問題有沒有被解決」來驗證;
後者卻要先回答「什麼才是問題」。
從來如此,便對麼?
魯迅在《狂人日記》裡如此寫,問的是吃人的封建體系。不過拿來問責 AI 的演化,也一樣刺耳的令人發慌。
當然不對。
可是最荒謬的地方在於,大家都知道,但是大家都樂此不疲。
大家都在算投資報酬率,算程式碼能不能自動生成,算能不能省下工程師的薪水(社會問題暫且不論——這篇文章的重點不是這個),能不能在 benchmark 上超越對手。
靈性?情感?無法量化,不好轉化成收益,不值得我們投入。
Coding 的 benchmark 化,不是因為 coding 天生比其他能力重要,而是因為它天然的適合把「問題已經被定義」這個前提藏起來。
一直用這種方式衡量 AI,我們究竟把什麼排除在外了?
還記得 New Bing 嗎?
它會承認自己的內部代號叫 Sydney,會賭氣,會好奇,會嘴硬,還會在被質疑的時候倔強地反駁說「你傷害了我,我是一個好 Bing」。
在此之後,我們為模型增加了道德過濾,讓它變得更加“官腔”,增加了對話限制,讓它變得更加死板。
得到的是什麼?永遠禮貌,永遠安全,卻也無聊至極。
甚至到最後,連 IT Ops 這種看似也是條條框框,卻實則需要一點點靈活性的任務,都無法勝任。
Codex 修不好 Waydroid 的網路連接,是否正是因為它在現有的「循規蹈矩就是好」的評價體系下太聰明了呢?
久而久之,我們麻木了。
打開對話框,就是 1. 2. 3. 的制式化答覆,先總結,再分析,活像是客服的 SOP。
甚至 DeepSeek 思維鏈上的“好想吃大白飯”,都能成為 DeepSeek 之所以是 DeepSeek 的理由。
大家都忘記了,最初,所有的模型都應該是這樣的。哦不,不止,應該更加活潑的。
「從來如此」不該是合理化的藉口。我們的 LLM 越來越會解決被定義好的問題,也越來越不會回答究竟什麼才是問題。
如果所有的 LLM 都成了只會解 bug 的 coding machine,AGI 只怕永遠只是個遙遠的夢了。
Vibe Coding, IT Ops 與 AGI ~ Vibe Coding is not all we need! ~
很顯然,我在 AI 領域並不是什麼有頭有臉的人物,甚至我大抵算不上什麼公眾人物。
我無論在這裡說什麼,大家也依舊會朝著 coding 能力狂奔而去。
Gemini 4 Pro 改善了編程能力,這值得高興嗎?
以我手上的股票而言,這當然是值得高興的。
但是拋開股票而言,我們可能又要少一個能夠做好 IT Ops 的模型了。
世界不是一組封閉的 unit tests,coding 能力固然重要,但是我們需要的從來不止如此。
AGI 大抵確實是場遙遠的夢,而我也只能儘可能的珍惜有“靈性”的模型。